Búsqueda uniforme en optimización: medir el terreno punto a punto

Imagen de Jack Bain extraída de Unsplash
El Método de Búsqueda Uniforme (también conocido como Búsqueda Exhaustiva por Malla o Grid Search Unidimensional) es uno de los algoritmos directos más elementales e intuitivos en optimización numérica. Se utiliza para minimizar o maximizar una función no lineal de una sola variable $f(x)$ en un intervalo cerrado y acotado $[a, b]$, sin necesidad de calcular derivadas.
A mediados del siglo XX, con el nacimiento de la investigación operativa y el cálculo computacional en las décadas de 1950 y 1960, surgió la necesidad de resolver problemas de optimización no lineal donde las funciones objetivo eran complejas, costosas de evaluar o no diferenciables.
El estudio formal de los métodos de búsqueda unidimensional fue sistematizado por Douglass J. Wilde en su célebre libro Optimum Seeking Methods (1964) (Wilde, 1964). Wilde clasificó los algoritmos de búsqueda no lineal en dos grandes categorías:
- Métodos Simultáneos: Todos los puntos de evaluación se eligen de antemano antes de realizar cualquier cálculo.
- Métodos Secuenciales: Las evaluaciones futuras depende de los resultados obtenidos en las evaluaciones anteriores.
La Búsqueda Uniforme se estableció como el estándar fundamental de los métodos simultáneos, sirviendo como la base conceptual para el desarrollo del análisis de eficiencia en optimización numérica.
El algoritmo de búsqueda uniforme
El objetivo principal de la Búsqueda Uniforme es reducir el intervalo inicial $[a, b]$ donde se encuentra el mínimo global de una función continua y unimodal $f(x)$.
El funcionamiento se basa en los siguientes puntos:
-
Discretización: Dado un entero \(n \geqslant 2\), dividimos el intervalo $[a, b]$ en $n$ subintervalos de igual longitud:
\[\Delta x = \frac{b - a}{n}\] -
Generación de puntos: Se generan $n + 1$ puntos distribuidos de forma uniforme: \(x_i = a + i \cdot \Delta x \quad \text{para } i = 0, 1, 2, \dots, n\)
-
Evaluación: Se evalúa la función objetivo $f(x_i)$ en cada uno de los puntos discretizados.
-
Localización del mínimo (máximo): Se identifica el punto $x_k$ que produce el menor (mayor) valor registrado $f(x_k)$.
-
Subintervalo del mínimo (máximo): Por la propiedad de unimodalidad, el mínimo (mayor) real $x^*$ queda acotado dentro del subintervalo formado por los vecinos del punto mínimo (máximo) hallado:
\[x^* \in [x_{k-1}, x_{k+1}]\]La longitud del nuevo intervalo es $2 \Delta x = \frac{2(b - a)}{n}$.
Pseudocódigo
A continuación se presenta la formulación algorítmica estructurada:
\begin{algorithm}
\caption{Búsqueda Uniforme Unidimensional}
\begin{algorithmic}
\PROCEDURE{BusquedaUniforme}{$$f, a, b, n$$}
    \STATE $$deltax = (b - a)/n$$
    \STATE $$xopt = a$$
    \STATE $$fopt = f(a)$$
    \STATE $$k = 0$$
    \FOR{$$i = 0$$ \TO $$n$$}
        \STATE $$xi = a + i * deltax$$
        \STATE $$val = f(xi)$$
        \IF{$$val < fopt$$}
            \STATE $$fopt = val$$
            \STATE $$xopt = xi$$
            \STATE $$k = i$$
        \ENDIF
    \ENDFOR
    \STATE $$liminf = $$\CALL{max}{$$a, a + (k - 1) * deltax$$}
    \STATE $$limsup = $$\CALL{min}{$$b, a + (k + 1) * deltax$$}
    \RETURN $$xopt, fopt, [liminf, limsup]$$
\ENDPROCEDURE
\end{algorithmic}
\end{algorithm}
Ejemplo numérico
Consideremos el problema de minimizar la función no lineal:
\[f(x) = x^2 - 3.2x + 3\]en el intervalo $[a, b] = [0, 3]$ utilizando $n = 6$ subintervalos.
Analíticamente, derivando $f’(x) = 2x - 3.2 = 0$, sabemos que el mínimo se encuentra en $x^* = 1,6$ con $f(1,6) = 0.44$).
El incremento viene dado por:
\[\delta x = (3 - 0)/6 = 0,5\]y la evaluación en la malla de puntos:
| $i$ | $x_i = a + i \cdot \Delta x$ | Evaluación $f(x_i) = x_i^2 - 3.2x_i + 3$ |
|---|---|---|
| 0 | $0,0$ | $(0)^2 - 3.2(0) + 3 = 3,00$ |
| 1 | $0,5$ | $(0,5)^2 - 3.2(0,5) + 3 = 1,65$ |
| 2 | $1,0$ | $(1,0)^2 - 3.2(1,0) + 3 = 0,80$ |
| 3 | $1,5$ | $(1,5)^2 - 3.2(1,5) + 3 = 0,45$ |
| 4 | $2,0$ | $(2,0)^2 - 3.2(2,0) + 3 = 0,60$ |
| 5 | $2,5$ | $(2,5)^2 - 3.2(2,5) + 3 = 1,25$ |
| 6 | $3,0$ | $(3,0)^2 - 3.2(3,0) + 3 = 2,40$ |
Observando estos resultados:
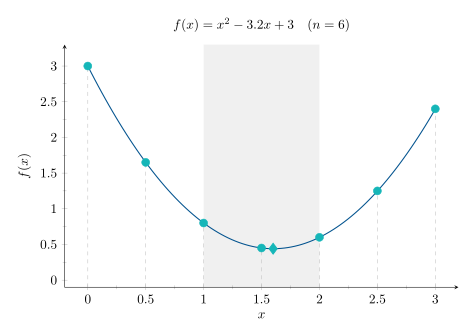
- El menor valor de la función alcanzado en la malla es $f(x) = 0,45$, alcanzado en el punto $x = 1,5$.
- Tomando $x_k = 1,5$ el subintervalo delimitado por sus puntos adyacentes es: \(x^* \in [1,0; 2,0]\)
- Resultado: El rango de búsqueda inicial de longitud $3,0$ se ha reducido a una región de longitud 1, garantizando que el óptimo $x^* = 1,6$ se encuentra en su interior.
El procedimiento anterior se puede observar gráficamente en la siguiente figura:
Análisis técnico y aplicaciones prácticas
Para que el intervalo final tenga una amplitud \(2\Delta x < \varepsilon\), se debe elegir un valor \(n\) suficientemente grande que viene dado por:
\[\varepsilon > 2\Delta x = \frac{2(b-a)}{n}\]y, por tanto, se debe elegir:
\[n > \frac{2(b-a)}{\varepsilon}\]Ventajas, limitaciones y aplicaciones prácticas del algoritmo
- Ventajas:
- No requiere derivadas: Funciona sobre funciones discontinuas.
- Paralelización nativa: Al ser un método simultáneo, todas las $n$ evaluaciones son independientes entre sí y pueden calcularse simultáneamente en múltiples núcleos o GPUs.
- Limitaciones:
- La cantidad de evaluaciones crece linealmente con la precisión deseada, resultando ineficiente si el coste computacional de evaluar $f(x)$ es muy elevado.
En la práctica actual, la Búsqueda Uniforme se utiliza principalmente en búsqueda de hiperparámetros (Grid Search) en Aprendizaje Automático y como fase de exploración preliminar para acotar regiones de interés antes de aplicar métodos de refinamiento local.
Extensión al caso multivariable
El principio de la Búsqueda Uniforme se puede extender directamente al caso de optimizar funciones de múltiples variables $f(x_1, x_2, \dots, x_d)$ sobre un dominio acotado hiperrectangular $[a_1, b_1] \times [a_2, b_2] \times \dots \times [a_d, b_d]$.
En $d$ dimensiones, en lugar de dividir un segmento de recta, se construye una malla o hipercuadrícula (grid) en el espacio de parámetros. Si asignamos $n$ subintervalos de igual tamaño a cada una de las $d$ dimensiones, dividimos cada eje $j$ con un paso:
\[\Delta x_j = \frac{b_j - a_j}{n}\]El algoritmo evalúa la función en todas las combinaciones posibles de puntos de la malla y selecciona la tupla de coordenadas $(x_1, x_2, \dots, x_d)$ que minimiza $f$.
La Explosión Combinatoria
Aunque la extensión conceptual es trivial, la Búsqueda Uniforme sufre drásticamente lo que Richard Bellman denominó la maldición de la dimensionalidad (curse of dimensionality).
El número total de evaluaciones numéricas $N$ necesarias para cubrir el espacio crece de forma exponencial con el número de dimensiones $d$:
\[N = (n + 1)^d\]Para ilustrar este crecimiento combinatorio:
- 1 variable ($d = 1$) con $n = 100$: requiere $101$ evaluaciones (insignificante).
- 2 variables ($d = 2$) con $n = 100$: requiere $10.201$ evaluaciones (viable).
- 3 variables ($d = 3$) con $n = 100$: requiere $1.030.301$ evaluaciones (empieza a ser costoso).
- 5 variables ($d = 5$) con $n = 100$: requiere $10.510.100.501$ evaluaciones (computacionalmente inviable).
Cada nueva variable multiplica el esfuerzo computacional por un factor de $(n + 1)$, haciendo imposible utilizar mallas finas cuando el espacio de búsqueda tiene una dimensión moderada o alta.
Por todo ello, para el caso multivariable, este método no es recomendado.
La Búsqueda Uniforme representa la piedra angular de los métodos de optimización no informados. Aunque su simplicidad la vuelve ineficiente para problemas complejos de gran escala, su principio de muestreo sistemático constituye la base conceptual de técnicas modernas como el Grid Search en Machine Learning, demostrando que, antes de acelerar con gradientes o heurísticas, el primer paso siempre es saber explorar el terreno de forma ordenada y rigurosa.
¿Quieres seguir explorando el mundo de la Investigación Operativa? Descubre más posts sobre el tema aquí.
Si encontró esto útil, puede citarlo como:
Martín-Campo, F. Javier (Oct 2026). Búsqueda uniforme en optimización: medir el terreno punto a punto. https://www.fjmartincampo.com/blog/2026/nlunifsearch/.
o en formato BibTeX:
@misc{martín-campo2026búsqueda-uniforme-en-optimización-medir-el-terreno-punto-a-punto,
  title   = {Búsqueda uniforme en optimización: medir el terreno punto a punto},
  author  = {Martín-Campo, F. Javier},
  year    = {2026},
  month   = {Oct},
  url     = {https://www.fjmartincampo.com/blog/2026/nlunifsearch/}
}
Referencias
- Book
¿Le gustó leer este artículo?
Aqui están algunos artículos relacionados que le pueden gustar: